
Anthropic发布Claude Opus 4.8:编程基准得分69.2%,快速模式成本降至前代三分之一
Anthropic于5月29日发布旗舰模型Claude Opus 4.8,官方称其在SWE-Bench Pro编程基准上取得69.2%,并新增“努力程度”控制功能,快速模式运行速度为前代2.5倍,实际模型成本为前代的三分之一。
海宇数科 · 事件日期 · 更新于 · 约 2 分钟 · 1 次阅读
Anthropic于5月29日推出新一代旗舰模型Claude Opus 4.8。据官方介绍,此次升级面向用户在编程与智能体任务中的实际需求,在价格体系保持不变的前提下,加强了智能体编程、复杂逻辑推理及多领域知识工作方面的能力。
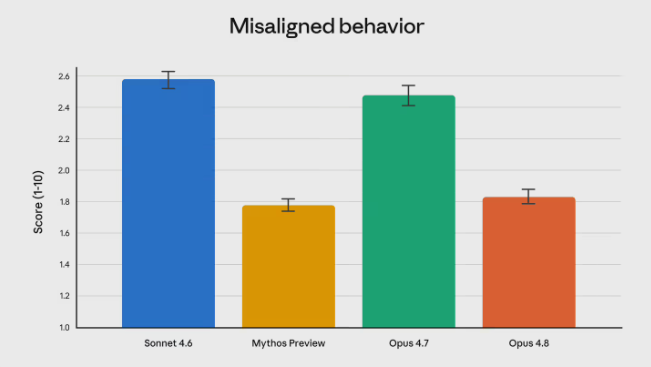
在AI编程与智能体任务上,早期测试机构的反馈显示,Opus 4.8的日常表现更稳定,判断也更为敏锐。面对多步骤复杂任务,该模型表现出较高的可靠性,并会在计划不合理时主动提出异议、标注不确定性。评估数据表明,模型写出有缺陷代码却不加说明的概率降至前代的四分之一,无依据结论的产生也随之减少。
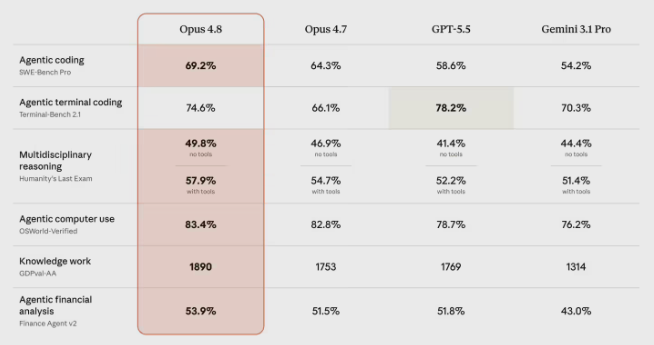
基准测试方面,官方数据显示Opus 4.8在编程基准SWE-Bench Pro上取得69.2%的成绩,并在多项主流基准测试中超过GPT-5.5与Gemini 3.1 Pro。
用户体验与计算成本方面,Claude平台新增“努力程度”控制功能,用户可在质量优先与响应速度优先之间切换。官方称,快速模式下新模型运行速度为前代的2.5倍,实际消耗的模型成本仅为前代的三分之一。