
谷歌为Chrome 149引入Gemini 3.5 Flash屏幕框选提问功能
谷歌在Chrome 149浏览器中集成Gemini 3.5 Flash模型,推出“从屏幕选择”交互功能,支持用户框选网页局部内容直接向AI提问,同时该模型将计算机操作能力内置为主模型工具。
海宇数科 · 事件日期 · 约 2 分钟 · 1 次阅读
谷歌在Chrome 149浏览器中集成Gemini 3.5 Flash模型,新增“从屏幕选择”(Select from screen)功能,用户可框选屏幕局部内容与AI定向对话,无需在模型或工具间切换。
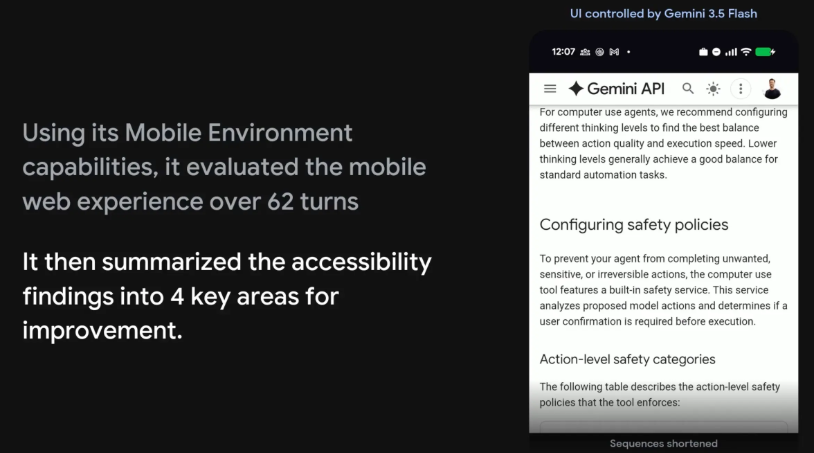
谷歌同期将计算机操作(computer use)作为内置工具整合进Gemini 3.5 Flash主模型,此前该能力仅以独立的Gemini 2.5计算机操作模型形式提供。
告别全局上传,精准锁定网页局部信息
按谷歌更新公告的描述,用户使用Chrome内的Gemini时,可用光标勾勒出需要提问的特定区域,被框选的图片或文本会自动作为附件,与用户输入的提示词实时组合。
这一操作与Google Lens类似,区别在于选中的局部内容不会跳转到传统搜索结果页,而是直接送入对话式AI架构,由智能体针对细节给出解答。
赋能三大场景,端侧体验迎来全面革新
该功能带来的体验升级体现在多个场景:在购物网站框选几双鞋子,让AI分析哪款更贴合自己的运动风格;框选复杂图表获取更清晰的解释;或选择网页中的设计元素进行创意重塑。
谷歌在关于Gemini 3.5 Flash计算机操作的公告中说明,该能力现为模型内置工具,开发者可通过Gemini API和Gemini Enterprise Agent Platform调用,用于构建能在浏览器、移动端和桌面环境中执行访问网站、填写长表单、点击按钮和收集数据等任务的智能体。