
Meta 推出迄今最小多模态模型 Muse Ember,1M 上下文面向智能体高频子任务
Meta Superintelligence Labs 发布 Muse 品牌第四款模型 Muse Ember,规模为系列最小,主打高效多模态推理,面向智能体重复性子任务,支持 100 万 Token 上下文与 51.2 万 Token 输出,纯托管运行,输入每百万 Token 定价 0.10 美元。
海宇数科 · 事件日期 · 约 4 分钟 · 3 次阅读
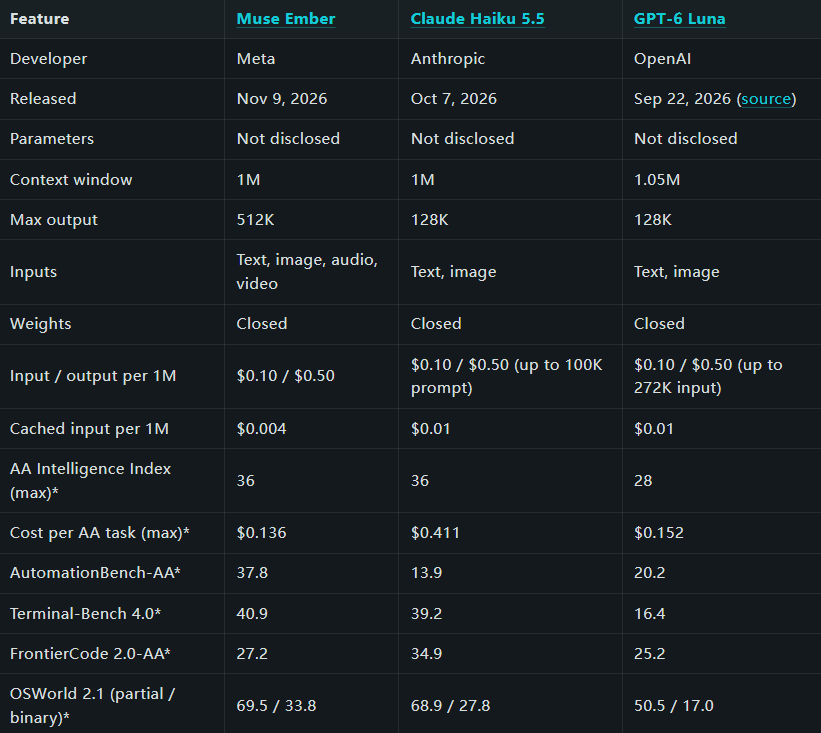
Meta Superintelligence Labs 发布 Muse Ember,这是 Muse 品牌旗下第四款模型,也是该系列迄今规模最小的一款。该模型定位为高效多模态推理模型,主要面向智能体中重复性较高的子任务。
核心定位:专注智能体高频子任务,实现精细化分工
在 Muse 产品线中,旗舰模型 Muse Wonder 负责复杂规划与难题求解,Muse Spark 承担编码与智能体工作流处理,而 Muse Ember 则聚焦重复性编码以及智能体子任务。
Muse Ember 的核心场景覆盖工具调用、编码子任务、路由、信息提取和长文档解析。通过这种精细化分工,Meta 希望提升智能体整体运行效率。
架构特性:原生多模态融合与百万级上下文窗口
Muse Ember 原生支持文本、图像、音频和视频输入,无需额外调用独立模型。它可以读取截图、图表、扫描页、语音备忘录和会议录音,还能通过截图操作桌面应用。
该模型的上下文窗口达到 100 万 Token,单次可容纳完整代码库或整个文档集合;最大输出为 51.2 万 Token,输出长度达到对手的 4 倍。
Muse Ember 采用纯托管模式,仅在 Meta 托管基础设施上运行,可通过 Meta Model API 和 Muse Code 调用。模型权重保持私有,不提供本地 GPU、笔记本或量化部署方案。
基准评测:智能体任务表现惊艳,代码合并场景稍逊一筹
相关评测由权威评测机构与 Meta 内部测试套件共同完成,测试时开启最大推理 effort。
在 AutomationBench-AA 的 657 个 Zapier 工作流测试中,Ember 任务完成率为 37.8%,GPT-6Luna 为 20.2%,Claude Haiku5.5 为 13.9%。在 Agents’ Last Exam 中,Ember 得 61.6 分,Haiku 得 57.0 分,Luna 得 57.1 分。
Terminal-Bench4.0 中,Ember 得 40.9 分,Haiku 得 39.2 分,Luna 得 16.4 分。AA 编码智能体指数上,Ember 以 46 分居首;但在 FrontierCode2.0-AA 中,Ember 得 27.2 分,低于 Haiku 的 34.9 分。
GDP.pdf-AA 中,Ember 得 22.8 分,与 GPT-6Luna 持平。OSWorld2.1 中,Ember 得 69.5 分,Haiku 得 68.9 分。PerceptionBench 中,Ember 得 80.6 分,Haiku 得 78.6 分,Luna 得 62.8 分。
AA 智能指数方面,Ember 得 36 分,与 Haiku5.5 持平,GPT-6Luna 得 28 分。
成本效益:基础定价相同,实际任务成本大幅优化
定价方面,Muse Ember 输入每百万 Token 为 0.10 美元,输出每百万 Token 为 0.50 美元,缓存输入每百万 Token 为 0.004 美元,缓存价格低于 Haiku 与 Luna。
按单次任务计算,Ember 成本约 0.136 美元,Haiku5.5 同类成本为 0.411 美元,约为对手的三分之一。
部分竞品在提示词超过 10K 或 272K 时会加价,而 Ember 没有长上下文加价档位。
生态接入与合作伙伴
Muse Ember 可通过 Meta Model API 和 Muse Code 接入,并支持 Responses API。Box、Cline、Oracle、Cloudflare 和 You.com 参与了早期测试。