
科大讯飞发布星火X2-Flash模型 支持256K上下文并开放API
科大讯飞推出星火X2-Flash模型,采用MoE架构、总参数30B,支持256K长上下文,基于昇腾910B集群训练,同步开放API。
海宇数科 · 事件日期 · 约 2 分钟 · 1 次阅读
科大讯飞于4月29日发布星火X2-Flash模型,API接口同步开放。该模型基于国产算力生态构建,面向智能体与代码生成等应用场景。
星火X2-Flash采用MoE(混合专家)架构,总参数量为30B,可处理最长256K的上下文。其训练在华为昇腾910B集群上完成。
在智能体(Agent)与代码生成方面,该模型能力有所增强。参考稿称,第三方实测显示其在深度研究报告、Skill管理与调用、系统控制执行等任务中的表现可对标业界万亿级参数模型;上述测试结论来自参考报道,尚待独立核实。
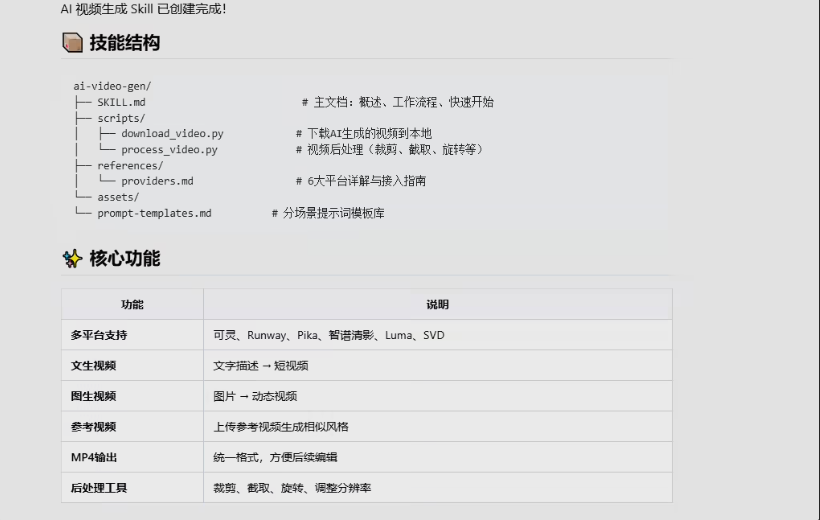
成本方面,参考稿称在相同工作流测试中,星火X2-Flash的Token消耗量约为主流大尺寸模型的三分之一。以视频生成技能创建为例,模型可理解需求并给出从技能结构到核心功能的说明。
技术层面,该模型在国产芯片上结合了DSA(稀疏注意力)与MTP(多Token预测)。参考稿称,这一组合使训练效率相比同规模集群提升4.5倍;针对智能体强化学习场景的算法与工程优化,则将采样推理效率提升2倍以上。相关数字来自参考报道,未获一手材料证实。
应用接入方面,AstronClaw、Loomy等应用已完成接入。该模型同时兼容OpenClaw、Claude Code等Agent框架,为开发者提供基于国产算力的方案。