
阿里开源0.8B文档解析模型OvisOCR2,登顶OmniDocBench
阿里巴巴于7月24日开源0.8B参数文档解析模型OvisOCR2,在OmniDocBench v1.6评测中以96.58分位列第一,成为首个整体超过传统流水线方法的端到端文档解析模型。
海宇数科 · 事件日期 · 约 2 分钟 · 1 次阅读
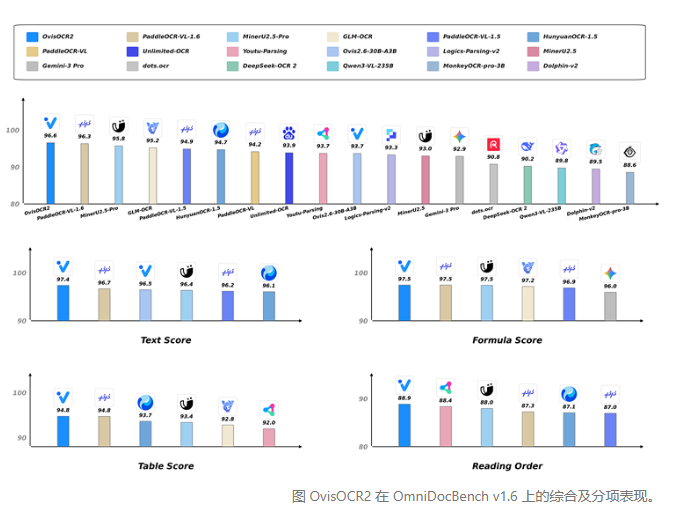
7月24日,阿里巴巴对外开源文档解析模型OvisOCR2,其参数规模仅为0.8B。该模型在OmniDocBench v1.6这一文档解析基准测试中取得96.58的综合得分并排名第一,也是端到端方案首次在整体表现上超过传统流水线方法。
文档解析是RAG检索、智能问答以及企业知识库的基础环节,过去主要依靠“版面分析+内容识别”的多阶段流水线串联完成,但这种模式存在维护成本偏高、误差会随环节传递累积、部署流程复杂等问题。OvisOCR2以Qwen3.5-0.8B为基础进行后训练,由单个模型一次生成,按照自然阅读顺序输出Markdown,内容覆盖文本、公式、表格和视觉区域。
在技术路线上,OvisOCR2将真实数据与合成数据配合使用,并借助监督微调(SFT)、强化学习(RL)、在线策略蒸馏(OPD)和模型融合四种方式,让紧凑参数规模的模型性能得到较充分发挥。
目前OvisOCR2已按Apache2.0协议在Hugging Face和魔搭社区开源,支持vLLM等主流推理框架,并可接入千问生态。参数规模较小意味着部署时对显存和算力的要求更低,高精度文档解析的落地门槛随之下降,文档智能的实现方式也从复杂系统工程转向更简洁的模型驱动路径。