
阿里开源统一科学大模型 LOGOS,1B 参数在核心任务上超过微软 8×7B 模型
阿里 ATH-Token Foundry 与中国人民大学高瓴人工智能学院联合开源多领域科学生成基础模型 LOGOS,以统一科学语法编码异构科学对象,1B 版本在多个核心任务上表现超过微软 8×7B 的 NatureLM。
海宇数科 · 事件日期 · 约 2 分钟 · 1 次阅读
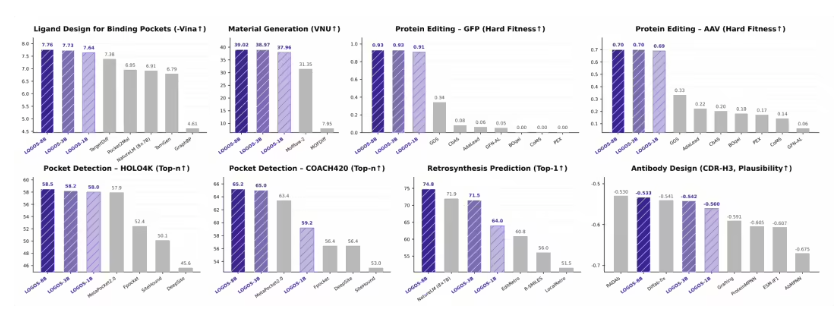
阿里 ATH-Token Foundry 与中国人民大学高瓴人工智能学院于 6 月 18 日宣布,开源多领域科学生成基础模型 LOGOS。该模型采用统一科学语法,在六项代表性科学任务中,以纯序列建模的方式达到或超过了各领域原有的专用方法。
参数效率是这一模型受到关注的重点。据披露,参数量为 1B 的 LOGOS-1B 在多个核心任务上的表现超过了参数量为 8×7B 的微软 NatureLM 语言模型。
首创科学语法统一异构对象
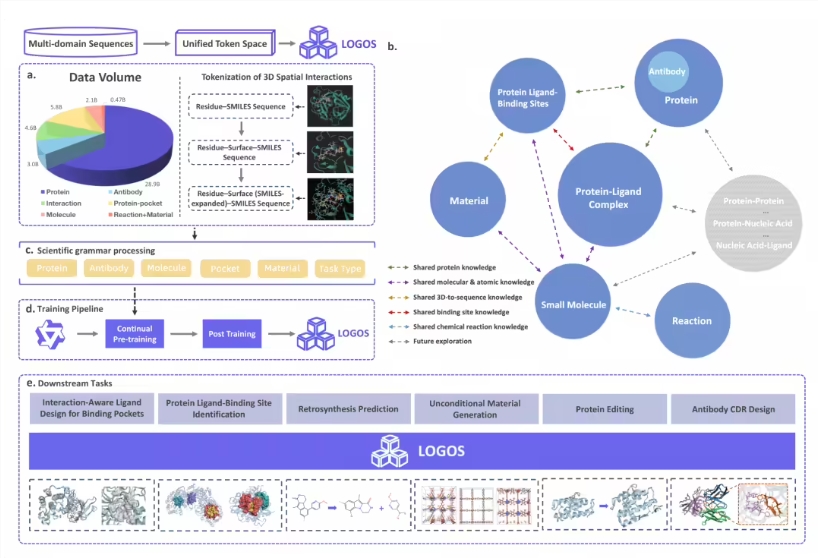
LOGOS 的预训练语料覆盖 7 类模态,总量达 44.87B tokens,内容包括生物大分子、化学实体以及界面互作等。模型借助一套共享词表,把蛋白质、小分子等原本结构不同的对象统一编码成离散 Token 序列。
按照这一设计,各类科学对象被放入同一个生成空间,由大模型以自回归方式加以理解。模型还采用了一种以文字描述替代复杂 3D 坐标输入的方式,仅通过序列预测来刻画空间互作规律。
彻底消除预训练与应用断层
以往科研流程中,研究环节一旦切换,往往就要更换模型,落地时还需大量微调。LOGOS 让预训练数据与下游任务在序列形式和输入输出上保持一致。
这种对齐使得预训练与下游应用之间无需额外的复杂适配层,即可直接调用生成能力。目前,模型权重、推理代码和技术报告均已完整开源。