
社区测试:40 核无显卡老旧服务器运行 2.8 万亿参数 Kimi K3,速度仅每秒不足 1.5 token
有玩家在社区分享称,用一台无显卡、搭载 40 核第三代至强处理器和已停产的英伟达傲腾持久内存 200 系列的老旧服务器,通过 llama.cpp 运行月之暗面 2.8 万亿参数的混合专家模型 Kimi K3;1bit 量化生成速度约每秒 0.85 token,关闭 DAX 后最高约每秒 1.5 token,3bit 量化约每秒 0.75 token,输出 5 万 token 耗时 18.5 小时。
海宇数科 · 事件日期 · 约 2 分钟 · 2 次阅读
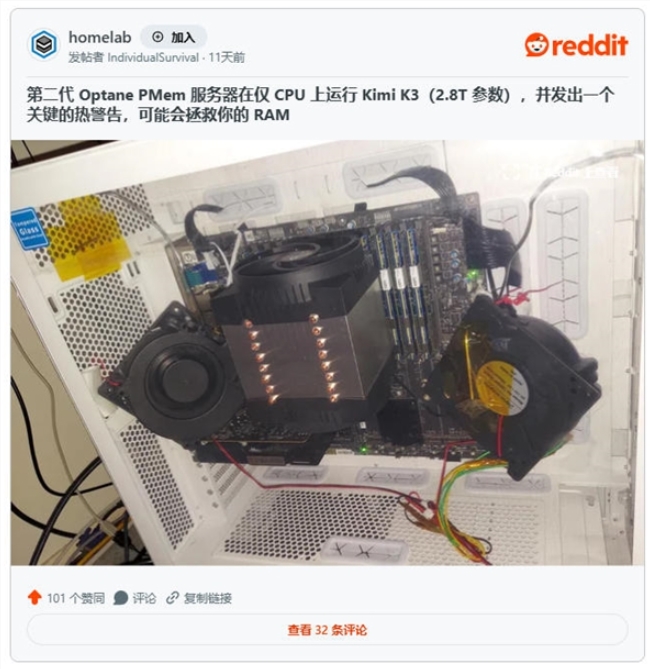
有玩家在社区分享了一次极限测试:在一台没有独立显卡、搭载 40 核处理器的老旧服务器上,尝试运行月之暗面发布的 2.8 万亿参数模型 Kimi K3。
挑战硬件极限:巨型大模型遇上老旧服务器
Kimi K3 属于混合专家模型,总参数量为 2.8 万亿,每个 token 激活约 1040 亿参数,上下文最高支持 104 万 token。
即便采用 1bit 量化,模型仍需数百 GB 内存,超出普通家用主板的承载上限。测试者为此选用 40 核第三代至强处理器,并搭配英伟达已停产的傲腾持久内存 200 系列,该内存单条最高支持 512GB。
巧妙软件调配:盘活停产傲腾内存作为主存
软件层面使用 llama.cpp,将傲腾内存设为 App Direct 模式,使其直接作为内存读写。
测试结果显示,运行速度较低。
1bit 量化下生成速度约每秒 0.85 token,关闭 DAX 后最高约每秒 1.5 token。
3bit 量化下速度约每秒 0.75 token,输出 5 万 token 耗时 18.5 小时。
该内存单条功耗上限为 18 瓦,介质温度达到 83 摄氏度开始降频,85 摄氏度则触发保护性关机。
英伟达于 2022 年第二季度收缩傲腾业务,当季库存减值 5.59 亿美元,且无下一代产品。