
淘宝MNN团队开源MNN-Pocket-0.3B,iPhone 18 Pro离线解码速度达350 token/s
淘宝MNN团队开源了轻量化大语言模型MNN-Pocket-0.3B,面向手机应用,在iPhone 18 Pro上实现离线解码约350 token/s,并在多项评测中超越同规模模型。
海宇数科 · 事件日期 · 约 3 分钟 · 1 次阅读
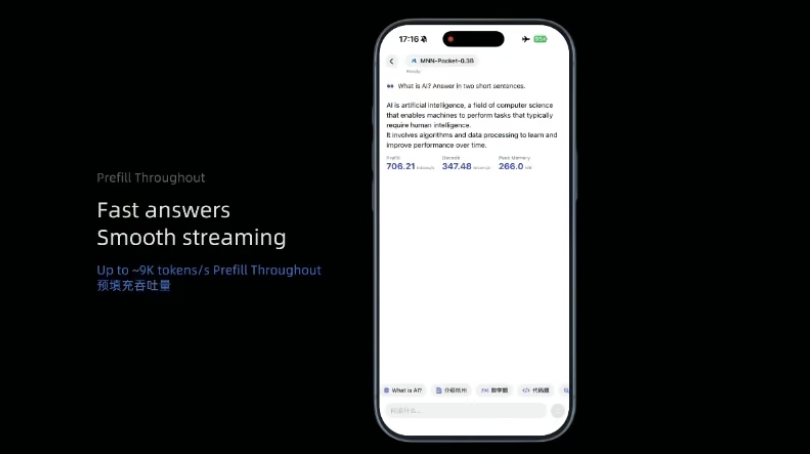
MNN团队开源了一款名为MNN-Pocket-0.3B的轻量化大语言模型,参数规模约3亿,面向手机应用场景,主打低内存占用、低能耗、高速响应与综合任务能力。
极致轻量化设计:体积缩减近半,峰值内存稳控在300MB以内
该模型专为手机应用原生设计,围绕四大核心指标打造:解码吞吐超过200 token/s、峰值内存低于300MB、单次推理能耗极低,并具备指令遵循与多任务扩展能力。
在实际性能表现上,该模型交出了亮眼的成绩单:
在iPhone 18 Pro真机测试中,借助MNN推理引擎完全离线运行,平均解码速度约350 token/s。在iPad Pro M5上使用Metal后端,Prefill吞吐达8721 token/s,Decode吞吐为466 token/s,约为Qwen3-0.6B的1.63倍。
INT4 MNN部署文件体积为173MB。在iPad Pro M5测试配置下,峰值内存增量为228MB。对比Qwen3-0.6B,其部署体积为340MB,峰值内存增量427MB,MNN-Pocket-0.3B部署体积缩减约49%,内存增量减少约47%。
在一加13(骁龙8至尊版)上进行4-bit模型功耗测试,基准负载下完成100次同等负载任务,累计增量能耗约占电池总电量的0.3%。
模型词表从约151K精简至64K,缩减幅度57%,从而降低词嵌入与输出层的参数开销。
综合能力越级挑战:多项评测登顶同规模模型之首
在实际任务表现上,该模型在学术基准评测中的成绩远超其参数体量。
英文IFEval得分73.20,中文指令遵循IFEval-zh得分74.59,11项综合评测平均得分50.00,超越MiniCPM4-0.5B与Qwen3-0.6B;中文数学MGSM-zh得分51.20,代码生成HumanEval得分53.66。
全版本全开源矩阵:赋能研究者与开发者生态
团队全流程开源了多个版本,包括预训练版本、后训练版本和端侧部署版本,以满足不同场景的适配需求。
MNN-Pocket-0.3B-Base用于继续预训练、领域适配及基础能力研究。
MNN-Pocket-0.3B-SFT面向后训练研究,可用于强化学习、蒸馏和消融实验。
MNN-Pocket-0.3B适用于通用指令调用和业务任务深度适配。
MNN-Pocket-0.3B-MNN是W4A16QAT端侧专属部署版本,基于MNN推理引擎、低比特算子与硬件后端优化,解码吞吐达466 token/s。
MNN-Pocket-0.3B-DFlash2是DFlash2投机解码草稿模型,采用块级生成与验证,解码吞吐达常规自回归解码的2.06倍。
MNN-Pocket-0.3B-Dec为决策头,面向候选选择类任务。