
阿里发布图像生成与编辑统一大模型Wan2.7-Image
阿里推出Wan2.7-Image图像生成与编辑统一大模型,强化虚拟角色捏脸、长文本渲染、交互式编辑与多主体一致性能力,并同步上线pro版本。
海宇数科 · 事件日期 · 约 2 分钟 · 1 次阅读
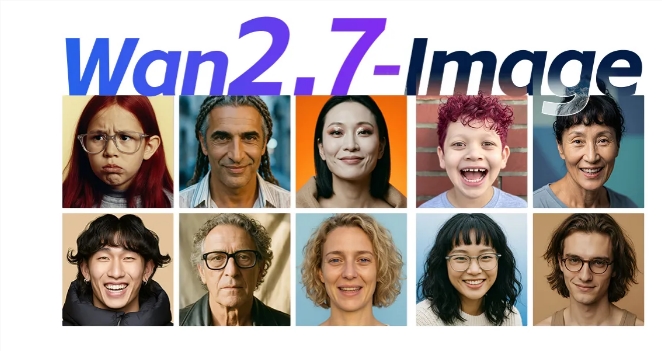
阿里于4月1日发布图像生成与编辑统一大模型Wan2.7-Image,针对以往AI生图人像趋同、指令对齐困难等问题进行了全链路能力升级。
告别 AI 脸,迈入“千人千面”时代
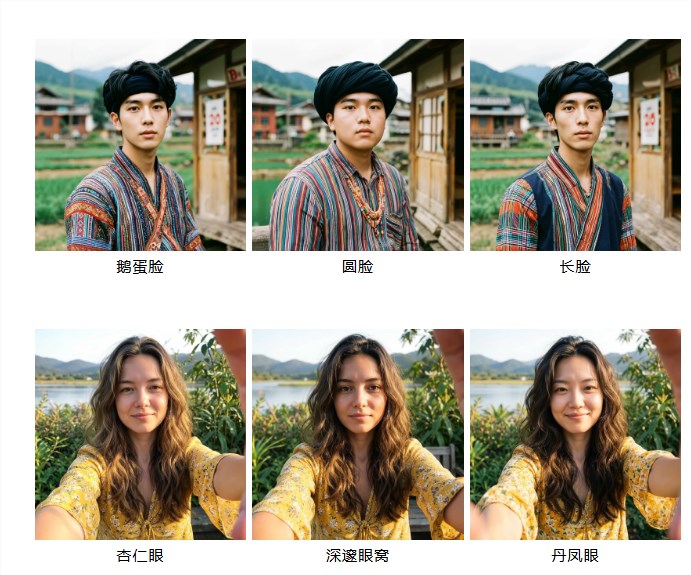
在虚拟角色塑造上,Wan2.7-Image强化了捏脸功能,用户可对骨相、眼眸及五官细节逐项调整,鹅蛋脸、丹凤眼、深邃眼窝等具体面部特征均能精准控制。
“调色盘”与“印刷级”文字渲染
模型新增“调色盘”功能,可从参考图中一键提取色调占比并迁移到新作品,例如马蒂斯的红色系或梵高的黄色系。长文本渲染方面,Wan2.7-Image支持最高3K token输入,能稳定输出含复杂公式与表格的整页A4纸内容,质量达到印刷级,覆盖12种语言。
交互式编辑与多主体一致性
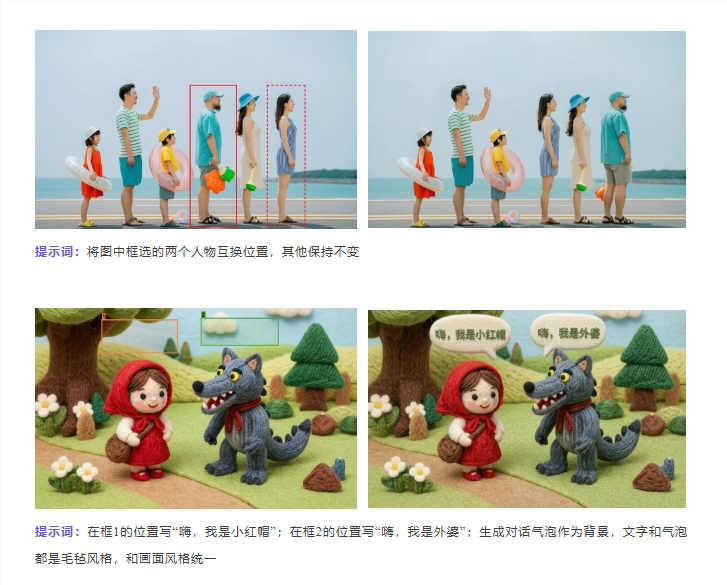
交互式编辑支持通过精准框选完成元素对齐、移动或替换,例如互换图中人物位置、将冰块替换为水果,实现像素级操控;模型最多支持9图多主体一致性,在生成AI女团或家具组合时可保持风格与特征统一。
底层技术突破与行业赋能
Wan2.7-Image采用生成与理解统一架构,在共享隐空间中实现语义映射,模型不再依靠猜测文字来拟合像素,而具备底层语义认知。
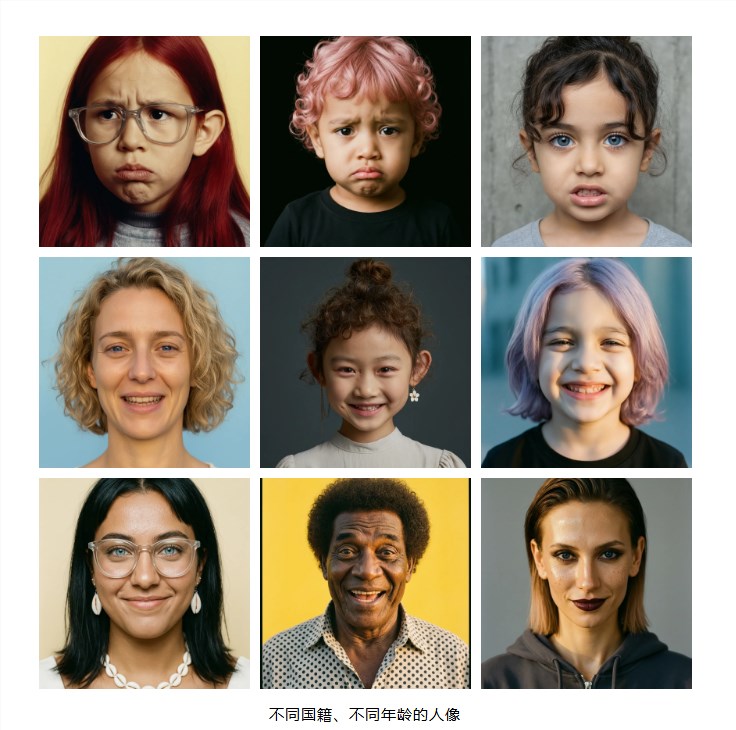
同步上线的Wan2.7-Image-pro版本在构图稳定性和理解精准度上进一步提升。
该模型已应用于短剧制作中一人分饰多角、电商广告模特图一生多,以及教育研究、社交娱乐等场景。
用户可通过阿里云百炼平台调用API,或前往万相官网直接体验。
根据公开信息,百炼平台提供国内站与国际站两个API接入入口。