
OpenAI 联合五家芯片与云厂商发布 MRC 协议,已开源至 OCP
OpenAI 与 AMD、博通、英特尔、微软、英伟达共同推出多路径可靠连接(MRC)协议,目标是在大规模 AI 训练中降低网络拥塞与链路故障带来的算力损失,协议已通过开放计算项目向行业开源。
海宇数科 · 事件日期 · 约 2 分钟 · 1 次阅读
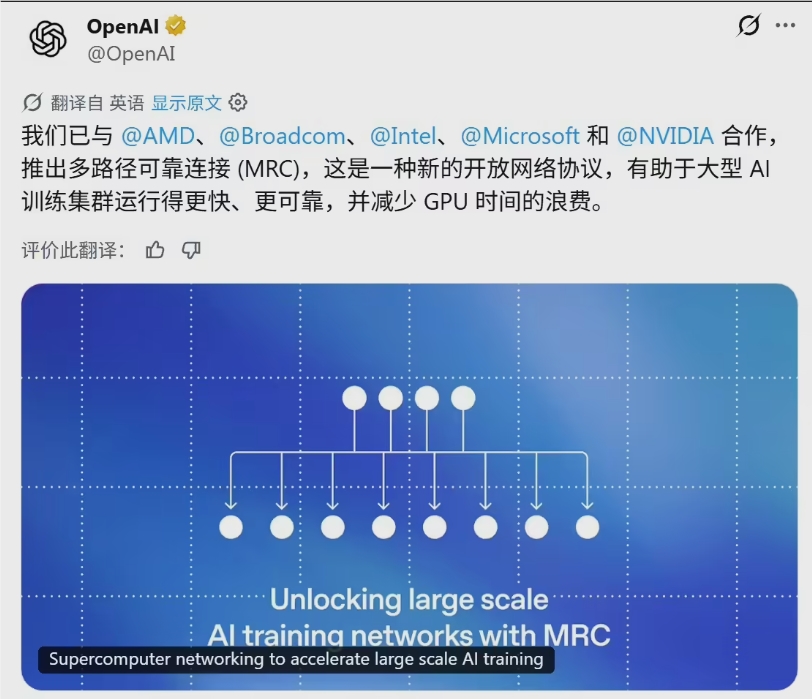
OpenAI 发布公告,宣布与 AMD、博通、英特尔、微软、英伟达共同推出多路径可靠连接(MRC)协议,并已借助开放计算项目向全球开源。该协议面向大规模 AI 训练中的网络延迟与链路故障问题,参与方覆盖芯片、系统与云基础设施多个环节。
击碎“单点故障”:从三层架构到两层设计的跨越
在大规模模型训练中,网络拥塞或单条链路出现轻微故障,可能让大量 GPU 同时进入等待状态,造成算力空转。MRC 通过多平面网络设计提升系统韧性,把单个 800Gb/s 接口拆分为多条更小的链路。
这一结构使系统用两层交换机即可支撑约 13.1 万块 GPU 的集群规模。与传统双层或四层架构相比,物理组件数量和能耗随之减少,建设成本也相应下降。
流量调度新方案:数据包“喷淋”与微秒级自愈
在流量分配上,MRC 采用自适应数据包喷淋技术,不再依赖单路径传输,而是把任务数据包分散到数百条路径并行发送。数据包即使乱序到达接收端,也能被准确重组,从而避开核心网络的局部拥塞。
网络控制方面,MRC 不使用 BGP 等复杂动态路由协议,改用 SRv6 源路由技术:由发送端直接指定路径,交换机执行静态转发。按发布方的说法,故障恢复时间可从秒级压缩到微秒级。
落地实测: 超级 计算机的“防抖”利器
MRC 协议目前已在英伟达 GB200 超级计算机和甲骨文云基础设施中投入实际应用。发布方称,在真实训练场景下遇到链路抖动或交换机重启时,MRC 能自动绕过故障点,使训练任务保持连续。
该协议的开源,意味着 AI 训练网络的设计思路正从单纯增加硬件投入转向架构层面的优化。多家厂商共同参与,目标是在大规模集群中兼顾网络的稳定性、效率与灵活性。