
豆包音频生成模型1.0发布,支持多模态参考与长时音色一致
火山引擎发布豆包音频生成模型1.0,主打多模态参考生成与长时音色一致性,用户输入含台词、情绪、背景音乐和环境氛围的Prompt即可生成完整音频成片。
海宇数科 · 事件日期 · 约 2 分钟 · 1 次阅读
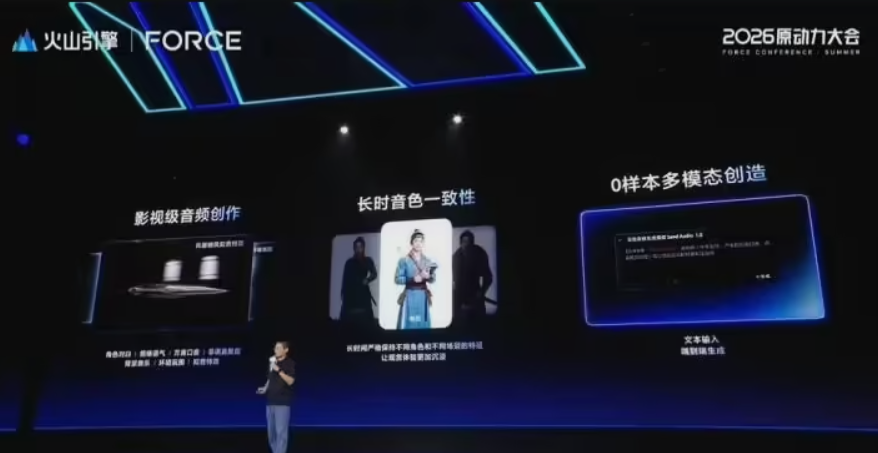
豆包音频生成模型1.0于6月23日正式发布。该模型以多模态参考生成和长时音色一致性为核心能力,试图将音频制作从分工生成、手动对齐混音的后期流程中解放出来。
在传统制作方式下,一段成片级音频需要分别完成对白、音效与配乐,再由创作者进行对齐和混音,对后期能力要求较高。豆包音频生成模型1.0将这一流程压缩为一次输入:用户提交一条包含角色台词、情绪语气、背景音乐和环境氛围的Prompt,模型直接输出具备叙事张力的完整音频。
长音频创作中角色音色漂移是常见问题。该模型让文生音频与参考音频深度联动,在多次音频延长的过程中保持角色声音特性稳定,从而面向有声书、播客等长程生成场景交付前后一致的音色。
模型还支持0样本多模态音频创造。创作者可通过文本描述或参考音频输入获得目标音频,无需额外训练;音色与风格控制实现解耦,并支持“一声多角”,即同一声音在不同情绪和场景下进行演绎。
目前,火山方舟已开放该模型的API邀测,个人用户可获取30分钟创作额度。该模型后续将上线剪映、即梦及番茄等平台。