
英伟达开源双塔扩散语言模型 Nemotron-Labs-TwoTower,权重已上线 Huggingface
英伟达于 7 月 2 日发布 Nemotron-Labs-TwoTower 离散扩散语言模型,相关权重已在 Huggingface 开放。该模型总参数 60B,由两座 30B 网络协同工作,据称文本生成吞吐速度可达原版 Nemotron 的 2.42 倍,综合能力保留约 98.7%。
海宇数科 · 事件日期 · 约 2 分钟 · 1 次阅读
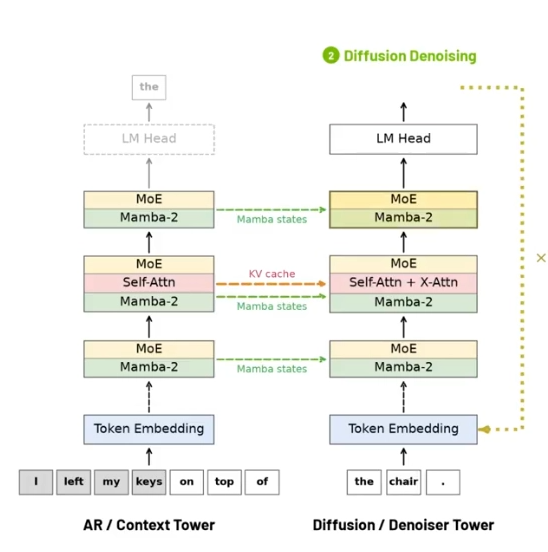
英伟达 7 月 2 日推出名为 Nemotron-Labs-TwoTower 的离散扩散语言模型,目标是缓解大模型逐个生成 Token 所带来的速度瓶颈,模型权重已在 Huggingface 开源。该模型在现有 Nemotron 骨干网络基础上改造而来,复用预训练权重,开发者无需从零完整训练,从而降低开发成本。
60B 双塔架构,分工并行提升生成效率
Nemotron-Labs-TwoTower 的总参数量为 60B,被拆分成两座各 30B 的独立神经网络协同运行,每塔激活 3B 参数,并配置 128 个可路由专家模块。其中上下文塔保持冻结,用于留存全文语义信息;去噪塔接受专门训练,借助扩散机制并行生成文本,两塔之间通过交叉注意力交换数据。
与逐个 Token 串行输出的传统模型不同,双塔架构能够并行写入文本,从而提高推理吞吐量。多类基准测试数据显示,该模型的综合能力保留原版约 98.7% 的水准,文本生成吞吐速度提升 2.42 倍,代码与数学类任务仅有小幅下滑。
开源落地,适配多场景推理部署
该模型以英伟达专属开源协议开放权重,开发者可下载测试并用于商用部署。运行方面,双塔完整推理需要两张 H100 或 A100 80GB 显卡协同,单卡仅支持纯自回归模式。测试覆盖常识、数学、代码、阅读理解等多项任务,多数指标与原版基本持平。