
Liquid AI 开源端侧混合专家模型 LFM2.5-8B-A1B
Liquid AI 发布并开源端侧大模型 LFM2.5-8B-A1B,采用稀疏混合专家架构,面向消费级硬件的工具调用与复杂指令遵循。
海宇数科 · 事件日期 · 约 2 分钟 · 1 次阅读
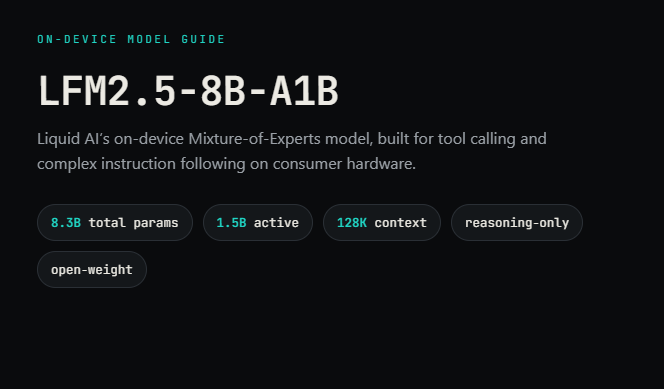
Liquid AI 于 5 月 29 日发布并开源了端侧大模型 LFM2.5-8B-A1B。该模型面向消费级硬件上的工具调用与复杂指令遵循场景,在压低计算成本的同时提升了本地设备的推理表现。
LFM2.5-8B-A1B 采用稀疏混合专家(MoE)架构,总参数量 8.3B。由于每次生成 Token 时只激活 1.5B 参数,模型可以在手机、笔记本电脑等本地设备上运行。
长文本扩展与推理能力升级
与上一代产品相比,LFM2.5 的上下文窗口由 32K 扩展至 128K 词元,预训练数据量从 12T 增加到 38T。该模型为纯推理模型,在给出最终答案之前会生成显式的思维链;其高压缩率词表对中文、阿拉伯文等九种语言的处理效率更高。
针对长链路推理中出现的逻辑死循环与幻觉,开发团队在训练中分两个阶段引入强化学习。偏好优化用于减少长链路推理中的“死循环”,专门的防幻觉奖励机制则让模型在遇到超出知识库的问题时主动拒绝回答。
端侧性能强劲与生态全面兼容
在逻辑推理与反幻觉基准测试中,LFM2.5 的得分较前代大幅提升;在指令遵循方面,其表现可与参数量更大的模型相比。工具调用方面,模型默认输出 Python 函数调用,并支持在系统提示词中切换为 JSON 格式。
发布首日,该模型已获得 llama.cpp、MLX、vLLM 和 SGLang 等主流推理生态的支持。硬件实测显示,其在 M5 Max 芯片上的解码速度为每秒 253 字节,在手机端约为每秒 30 字节,兼顾端侧运行的私密性与效率。