
百度开源文心5.5Flash Base:2800亿参数MoE模型,多项基准测试刷新同尺寸SOTA
11月5日,百度开源文心5.5Flash Base基座模型,采用MoE架构,总参数量2800亿、激活参数140亿,预训练Token达33.5万亿,在知识、推理、数学、代码、多语言、长上下文等多项基准测试中刷新同尺寸模型SOTA,超越DeepSeek-V4-Flash-Base和Hy3-preview-Base。
海宇数科 · 事件日期 · 约 2 分钟 · 1 次阅读
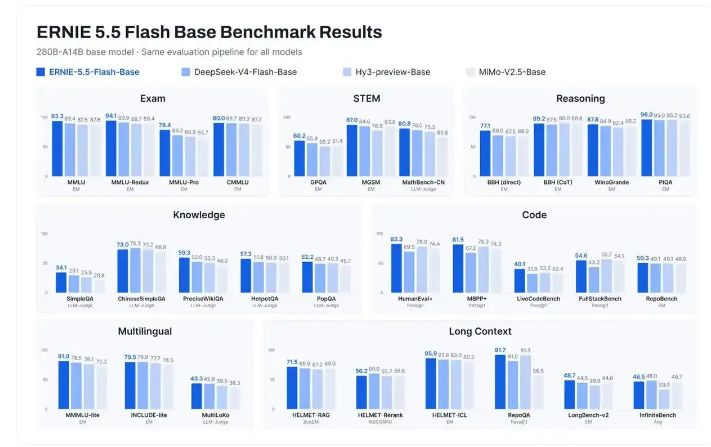
11月5日,百度开源了文心5.5Flash Base基座模型。该模型在知识、推理、数学、代码、多语言、长上下文等多项基准测试中刷新了同尺寸模型的SOTA,并超越了DeepSeek-V4-Flash-Base和Hy3-preview-Base。
文心5.5Flash Base基于MoE架构,总参数量为2800亿,激活参数140亿。其预训练Token规模达到33.5万亿,预训练上下文最高支持128K,微调与推理阶段最长可处理100万Token。
在系统层,该模型引入了算法创新:采用Latent-Gated Sparse Attention,将HCA与MLA组合,对历史信息进行压缩,并支持细粒度访问历史位置;使用低秩门控注意力,使门控投影权重减少75%;同时运用虚拟头注意力提升表达力。
模型采用Multi-Router Latent MoE,通过多个独立路由器改善专家选择效用。训练目标中引入ECHO,复用主干最后一层预测后续Token,从而免去额外的MTP模块。此外,百度优化了分布式Muon优化器,并推出FlashMask-4算子,以提升通信效率和显存利用效率。
此次开源有助于降低专业模型开发门槛,为开发者提供技术底座,支持构建定制化专业模型。