
美团开源LongCat-2.5:总参1.6万亿、激活约480亿,长序列SFT单卡吞吐较DDP提升86%
美团以MIT协议开源原生多模态模型LongCat-2.5,总参数1.6万亿、每token激活约480亿,支持一百万上下文;其长序列SFT配置在国产AI加速器上单卡吞吐较DDP基线提升86%,权重已上线HuggingFace。
海宇数科 · 事件日期 · 约 2 分钟 · 5 次阅读
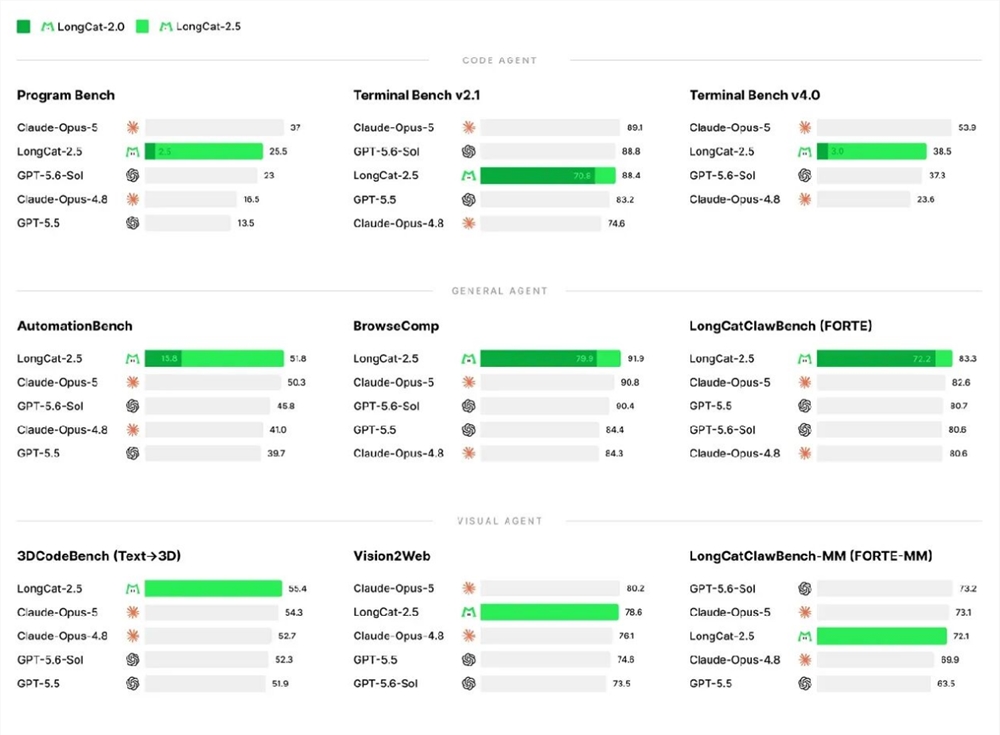
美团 LongCat-2.5 的模型权重现已在 Hugging Face 公开,采用 MIT 许可证,可在遵循许可条款的前提下用于商业部署与二次训练。11 月 10 日,模型仓库更新了模型卡与技术资料。该模型定位长程智能体任务,采用原生多模态架构,总参数1.6万亿,每个token约激活480亿参数,上下文长度支持一百万。在复杂代码库开发、完整项目构建、Visual Coding以及专业办公等场景中,模型端到端交付能力有较明显提升。LongCat API 此前已于 11 月 2 日上线这一模型。
上述能力来自训练链路各环节的整体扩展。视觉表征层把视觉信号编码为多层级离散token,与文本一样交由主干统一处理,并未采用外挂视觉模块的方式;该层对原生分辨率特征进行残差向量量化,逐级补足细节,视觉码本与主干联合训练,视觉token可离线缓存。专业办公方向则强化材料处理与专业判断,报告、演示文稿及办公工具能够端到端交付。
推理环节使用W4A4方案,专家权重与激活均量化至4bit,由原生INT4矩阵乘法单元执行运算;FlatQuant用于优化MoE量化精度,使下游表现与量化前相当,专用融合算子则进一步压低成本。训练与监督微调都采用长序列方式。面对国产AI加速器单卡显存不足80GB的限制,方案以FSDP双重分片和混合词表并行分摊显存压力;在这一配置下,长序列SFT的单卡吞吐量比DDP基线提高86%,为万亿参数MoE的开源部署提供了效率支撑。
美团称,选择MIT协议是为了支持模型被自由使用、修改与再分发,后续还会继续开放模型与工程经验。在显存和带宽受限的条件下承载万亿参数MoE,反映出大模型竞争正从参数规模转向工程落地与国产算力适配。