
谷歌推出全多模态嵌入模型Gemini Embedding 2,已在Gemini API与Vertex AI开放预览
谷歌发布基于Gemini架构的全多模态嵌入模型Gemini Embedding 2,可将文本、图片、视频、音频与PDF文档映射至同一向量空间,目前通过Gemini API和Vertex AI开放公共预览。
海宇数科 · 事件日期 · 约 2 分钟 · 1 次阅读
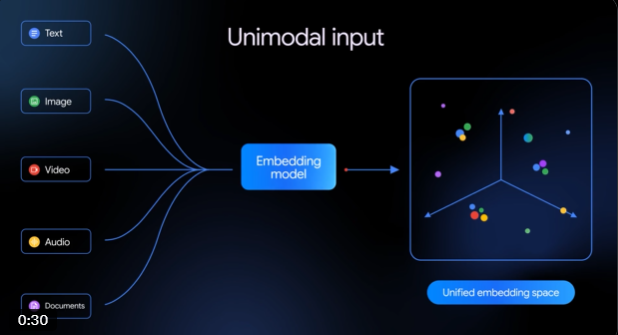
谷歌推出全多模态嵌入模型Gemini Embedding 2,该模型基于Gemini架构构建,可将文本、图片、视频、音频和PDF文档等多种数据类型映射至同一个嵌入向量空间。模型现已在Gemini API和Vertex AI上开放公共预览,开发者可以调用。
统一嵌入空间,打破模态壁垒
Gemini Embedding 2在架构上的主要特点,是让不同模态的数据共用同一嵌入空间。文本、图片、视频、音频和PDF文档经该模型处理后进入统一的向量表示体系,跨模态检索与分类由此可以在同一空间内完成,模型支持的语言超过100种。
混合输入能力,精准捕捉语义关联
该模型原生支持混合模态输入,可同时接收图片与文字、视频与音频等组合内容。系统处理的是不同媒体之间的语义关联,而非将各模态内容简单并列,这为理解多媒体内容提供了新的处理方式。
音频原生处理,无需ASR转录
音频方面,Gemini Embedding 2可直接接收原始音频文件并输出嵌入向量,无需先经过语音转文本环节。这一处理路径省去了ASR转录步骤,使多模态数据处理流程更为简化,同时有助于降低延迟与计算成本。
多场景落地,RAG迎来新纪元
依托统一架构和跨模态能力,Gemini Embedding 2可应用于RAG检索增强生成、语义搜索、情感分析、内容聚类以及法律证据检索等场景。