
英伟达推出约1亿参数免费语音分割模型Nemotron3 Diarization
英伟达发布约1亿参数的免费语音分割聚类模型Nemotron3 Diarization,开放权重,可识别最多8人同时发声并支持实时处理。
海宇数科 · 事件日期 · 约 2 分钟 · 1 次阅读
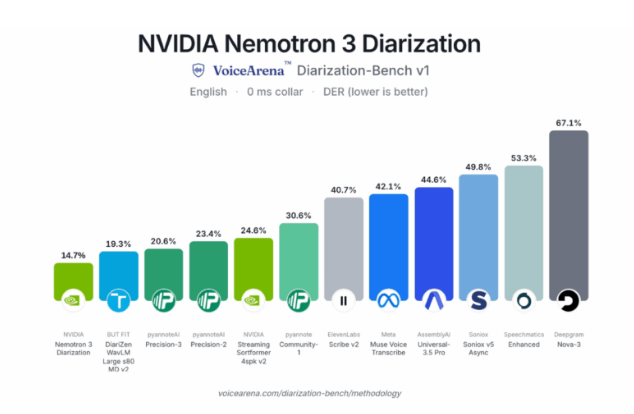
英伟达推出约1亿参数的免费语音分割聚类模型Nemotron3 Diarization,模型权重对外开放。该模型面向对话场景中的说话者识别任务,可处理实时音频与录音,最多支持8人同时发声。据披露,其在VoiceArena语音分割基准(v1)上以14.72%的错误率位居首位,对比第二名系统的19.3%具有优势。
在性能方面,英伟达将新模型与上一代Streaming Sortformer对比:在八项测试场景、使用1.04秒音频缓冲区时,平均错误率下降41%。为在识别准确率与响应延迟之间取得平衡,模型提供0.32秒至30.4秒四档动态音频缓冲区设置。
功能上,Nemotron3 Diarization可接入Parakeet等语音识别系统,为转写文本加上匿名说话者标签,例如“speaker_2”。英伟达同时说明,当参与人数增加、背景噪声偏大或混响明显时,模型错误率会随之上升;重叠语音等难点则依赖底层架构处理。
这款轻量级模型以免费开放的形式推出,降低了多说话人语音分析的使用门槛。其可用于实时会议记录、智能客服及多角色语音交互等场景,为相关应用提供底层能力支持。